Der größte Teil meiner Arbeit läuft inzwischen über ein KI-Setup, das ich mir selbst gebaut habe. Im Kern ist es nur eine Sammlung von Dateien, aus denen ein Modell liest und mit denen es täglich arbeitet. Heute funktioniert das gut, am Anfang aber nicht. Ich habe von Beginn an versucht, ihm eine klare Form zu geben, ohne schon zu wissen, welche Form ich eigentlich anstrebte. Ich arbeitete noch an der Strategie und baute gleichzeitig die einzelnen Bausteine, sodass sich das, was ich ordnen wollte, ständig unter mir verschob. Jede Arbeitssitzung hinterließ ein paar weitere Dateien, und jede hielt genau den Stand fest, den mein Denken an diesem Tag erreicht hatte.
So landete die Entwicklung selbst in den Dateien, verteilt über mehrere davon, weil ich weiterzog, bevor ich irgendetwas zusammenführte. Das Ganze wurde immer breiter und lief nie wieder zusammen, wie ein Diamant, der sich nach außen öffnet, aber nie zu einer Spitze schließt. Nach ein paar Wochen lagen die Entscheidungen, auf die es ankam, verstreut an einem Dutzend Stellen, und die Hälfte davon widersprach still der anderen Hälfte.
Das Modell kam damit nicht zurecht, und ich auch nicht. Bat ich es, von dem auszugehen, „was wir entschieden hatten", hatte es keine Möglichkeit zu wissen, welche Datei die Entscheidung enthielt und welche einen Entwurf, den ich längst verworfen hatte. Es zog eine alte Version heran oder las drei auf einmal und setzte daraus eine Antwort zusammen, die in keiner davon stimmte, überreicht mit voller Überzeugung und ohne jede Fehlermeldung.
Also baute ich es neu, und dann noch einmal. Ich ging vier- oder fünfmal durch das Ganze, bevor die Struktur, die ich heute habe, nicht mehr unter ihrem eigenen Gewicht zusammenbrach.
Was sich immer wieder herausbildete
Jedes Mal, wenn ich alles einriss und von vorn begann, sonderten sich dieselben Formen heraus. Ich setzte mich nicht hin, um eine Architektur zu entwerfen. Ich verschob nur das, was in der jeweiligen Woche am meisten wehtat.
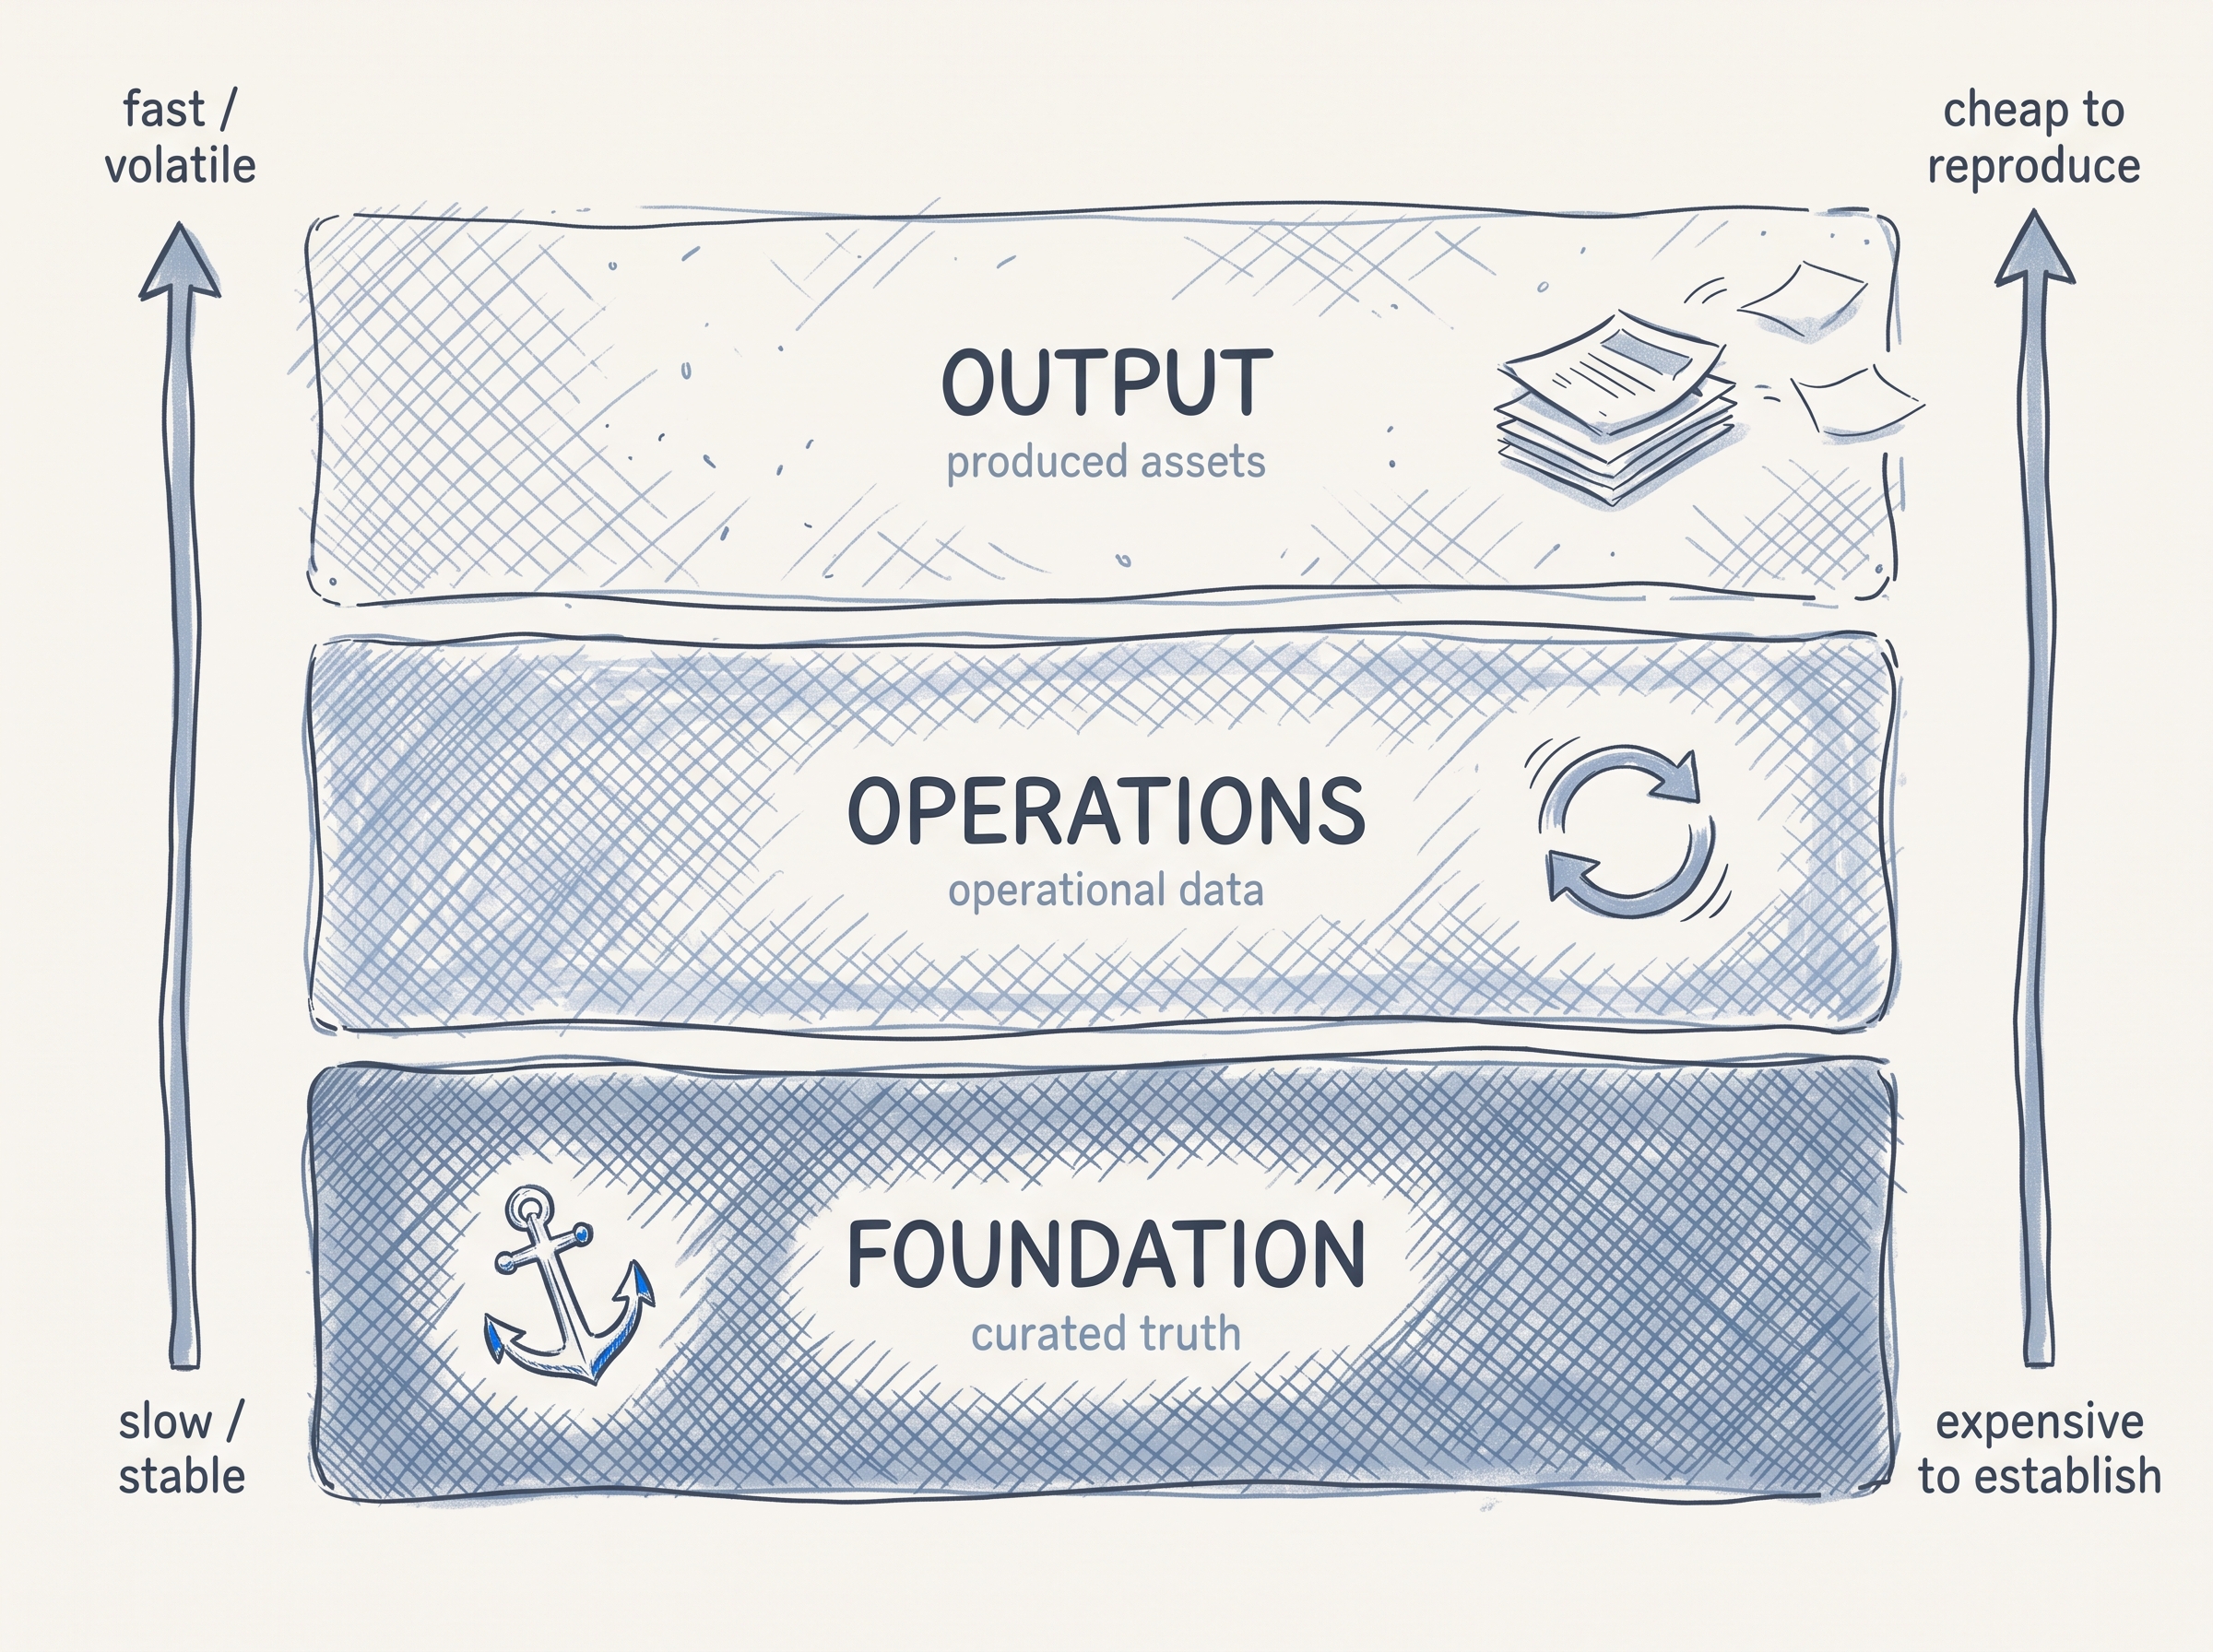
Das Erste, was sich herauslöste, war eine kleine Menge an Dingen, auf die ich ständig zurückgriff. Die finalen Entscheidungen. Die Positionierung, die Prinzipien, die Fakten, auf denen alles andere aufbaute. Die wollten an einem Ort liegen, für sich, weg vom Lärm. Daraus wurde ein foundation/-Ordner.
Dann bemerkte ich ein zweites Muster. Bestimmte wiederkehrende Arbeitsschritte brauchten aktuelle Daten, mit denen sie arbeiten konnten, und diese Daten änderten sich ständig. Kontakte, Pipeline, die operative Realität dessen, was gerade tatsächlich geschah. Auch das brauchte ein eigenes Zuhause, denn es verhielt sich völlig anders als die Foundation. Es war nie „fertig". Es wurde ständig aktualisiert und musste im großen Maßstab sauber gehalten werden. Ich nenne es operations/.
Alles Übrige war Output. Die Decks, die Entwürfe, die E-Mails, die Assets, die ich auf den anderen beiden erzeugte. Wegwerfbar von Natur aus. Ging etwas verloren, konnte ich es in Minuten neu erzeugen, solange die Foundation und die operativen Daten darunter solide waren. Daraus wurde output/.
Drei Ordner. Kein Framework hat mir gesagt, dass ich sie so bauen soll. Es war schlicht die einzige Form, die im echten Einsatz Bestand hatte.
Der Podcast, der es benannte
Ich erkannte das Muster erst als Muster, nachdem ich jemand anderen es beschreiben hörte. Christoph Magnussen war im OMR Tech Check und vertrat den Gedanken, man solle aufhören, KI als Sammlung von Tools zu begreifen, und anfangen, sie als Layer zu denken, als etwas, das man in Code baut und zentral orchestriert, statt als Schublade voller Apps, zwischen denen man wechselt. Er spricht von einem Layered-Prompt-System, das er an einer Stelle ändern und überall ausrollen kann, und von einem unsichtbaren Layer, der im Hintergrund auf einer Vektordatenbank läuft.
Seine Begriffe sind nicht meine. Die Aufteilung, die ich verwende, kuratierte Wahrheit unten, operative Daten in der Mitte, wegwerfbarer Output oben, ist meine eigene Synthese. Was der Podcast mir gab, war das Wiedererkennen. Ich hörte „Layer, nicht Tools", sah auf mein eigenes Repo und merkte, dass ich genau das seit Monaten gebaut hatte, ohne einen Namen dafür zu haben.
Da fing ich auch an, dasselbe Skelett überall sonst zu bemerken. Wer über Context Engineering schreibt, ist bei fast derselben Aufteilung gelandet: eine persistente Basis, die man cached, weil sie sich selten ändert, eine dynamische Mitte, die man pro Aufgabe austauscht, und eine flüchtige Spitze, die man klein hält und wegwirft. Geoffrey Moores altes Unternehmensmodell aus Systems of Record, Engagement und Intelligence hat dieselbe Struktur unter anderen Namen. Wenn mehrere Leute, die nie miteinander gesprochen haben, bei derselben Struktur ankommen, liegt das meist daran, dass die Struktur real ist, und nicht daran, dass sie denselben Blogartikel gelesen haben.
Warum die Schichten getrennt bleiben müssen
Hier kommt der Teil, für den ich fünf Neuaufbauten gebraucht habe, um ihn wirklich zu begreifen. Die Schichten zu trennen bringt etwas Wichtigeres als Ordnung. Jede braucht eine völlig andere Disziplin, um wahr zu bleiben, und wer sie vermischt, zerbricht alle drei auf einmal.
Die Foundation muss von Hand kuratiert und kompakt gehalten werden. Hier weiche ich davon ab, wie die meisten ihre Wissensbasis führen. Der Reflex, gerade bei der aktuellen Generation von Modellen, ist, alles zu behalten, weil sich mehr Kontext sicherer anfühlt. Meiner Erfahrung nach macht das die Sache schlechter, und die Modelle selbst tragen dazu bei. Sie dokumentieren gern ihre eigene Arbeit: Bittet man eines, einen Abschnitt zu überarbeiten und ein Argument zu streichen, macht es die Änderung und schreibt dann eine Zeile in dieselbe Datei, die erklärt, was es entfernt hat und warum. Diese Erklärung bleibt im Markdown stehen. Wochen später erzeugte ich aus derselben Datei eine Präsentation und sah, wie das gestrichene Argument wieder darin auftauchte, oder wie der Grund für die Streichung in einem fertigen Asset landete, das weder das eine noch das andere zu erwähnen hatte. Die Streichung war als Inhalt festgehalten worden, also verwendete das Modell sie als Inhalt.
Das ist nicht bloß mein Bauchgefühl. Wenn man es misst, erzeugt eine kuratierte Wissensbasis weit weniger Halluzinationen als eine unkuratierte bei exakt gleichem Retrieval, in einem Vergleich, den ich fand, etwa ein Sechstel so viele. Und der Fehlermodus ist genau der, auf den ich immer wieder stieß: Zieht ein Modell zwei einander widersprechende Inhalte heran, die behaltene Fassung und die gestrichene in derselben Datei, meldet es den Konflikt nicht. Es wählt still eine aus und überreicht das Ergebnis mit voller Überzeugung und ohne Fehler. Die Foundation auf die finalen Entscheidungen einzudampfen brachte mehr für die Output-Qualität als jedes Prompt-Tuning.
Die operative Schicht ähnelt der Foundation kaum. Sie ändert sich ständig, also besteht die Disziplin dort aus Validierung und ständiger Bereinigung. Und die Output-Schicht muss kaum geschützt werden, weil sie zum Wegwerfen gedacht ist. Vorlagen und billige Neuerzeugung genügen. Drei Schichten, drei Aufgaben. Versucht man, eine Disziplin über alle drei zu legen, bekommt man den Dateihaufen, mit dem ich angefangen habe.
Strategie ist nicht dasselbe wie operative Daten
Eine Trennung zählt mehr als die übrigen, und es ist die, die ältere Fassungen dieser Idee gern übersehen. Moore wirft Strategie und operative Daten in einen einzigen „System of Record". Ich halte sie strikt auseinander, und der Grund ist Geschwindigkeit.
Strategische Wahrheit sollte langsam sein. Ihr ganzer Wert liegt darin, dass sie stillhält. Ändern sich Positionierung oder Grundprinzipien jede Woche, ist das ein anderes Problem, und keine Ordnerstruktur rettet das. Operative Daten rechtfertigen sich nur, solange sie aktuell sind. Legt man beides an denselben Ort, muss man sich entscheiden: Entweder lässt man die schnellen Daten die Strategie destabilisieren, oder man lässt den langsamen Takt der Strategie die Daten veralten. Sie versagen in entgegengesetzte Richtungen, also brauchen sie verschiedene Adressen.
Die Schichten bauen, bevor man sie braucht
Wenn ich mir vor dem ersten Neuaufbau eine einzige Sache hätte sagen können, dann diese. Die drei Schichten kommen, ob man sie plant oder nicht. Entweder zeichnet man sie am ersten Tag ein, oder man entdeckt sie auf die teure Art, über vier oder fünf Abrisse, bei denen man Dateien umschichtet und Arbeit wegwirft, bis die Struktur sich schließlich aufzwingt.
Einen flachen Haufen nachträglich in diese Form zu bringen ist wirklich schwer. Mit drei leeren Ordnern zu beginnen kostet nichts. Wer also gerade irgendeine Art von Harness um ein Modell baut, zeichnet zuerst die Adressen ein. Man legt fest, wo die kuratierte Wahrheit liegt, wo die operativen Daten und wo der wegwerfbare Output, bevor man überhaupt etwas hat, das hineingehört. Dann hält man die Disziplin für jede Schicht getrennt und, vor allem, die Foundation kompakt. Man speichert die Entscheidung, nicht die Diskussion, die einen dorthin gebracht hat.
Ein Modell ist immer nur so gut wie die Wahrheit, auf die man es ausrichtet. Die meiste Arbeit besteht darin, diese Wahrheit leicht auffindbar zu machen.
Bereit für AI-Workflows, die sich aufbauen?
Ich helfe PM-Teams dabei, von Ad-hoc AI-Nutzung zu integrierten Systemen zu kommen.
Kontakt aufnehmen