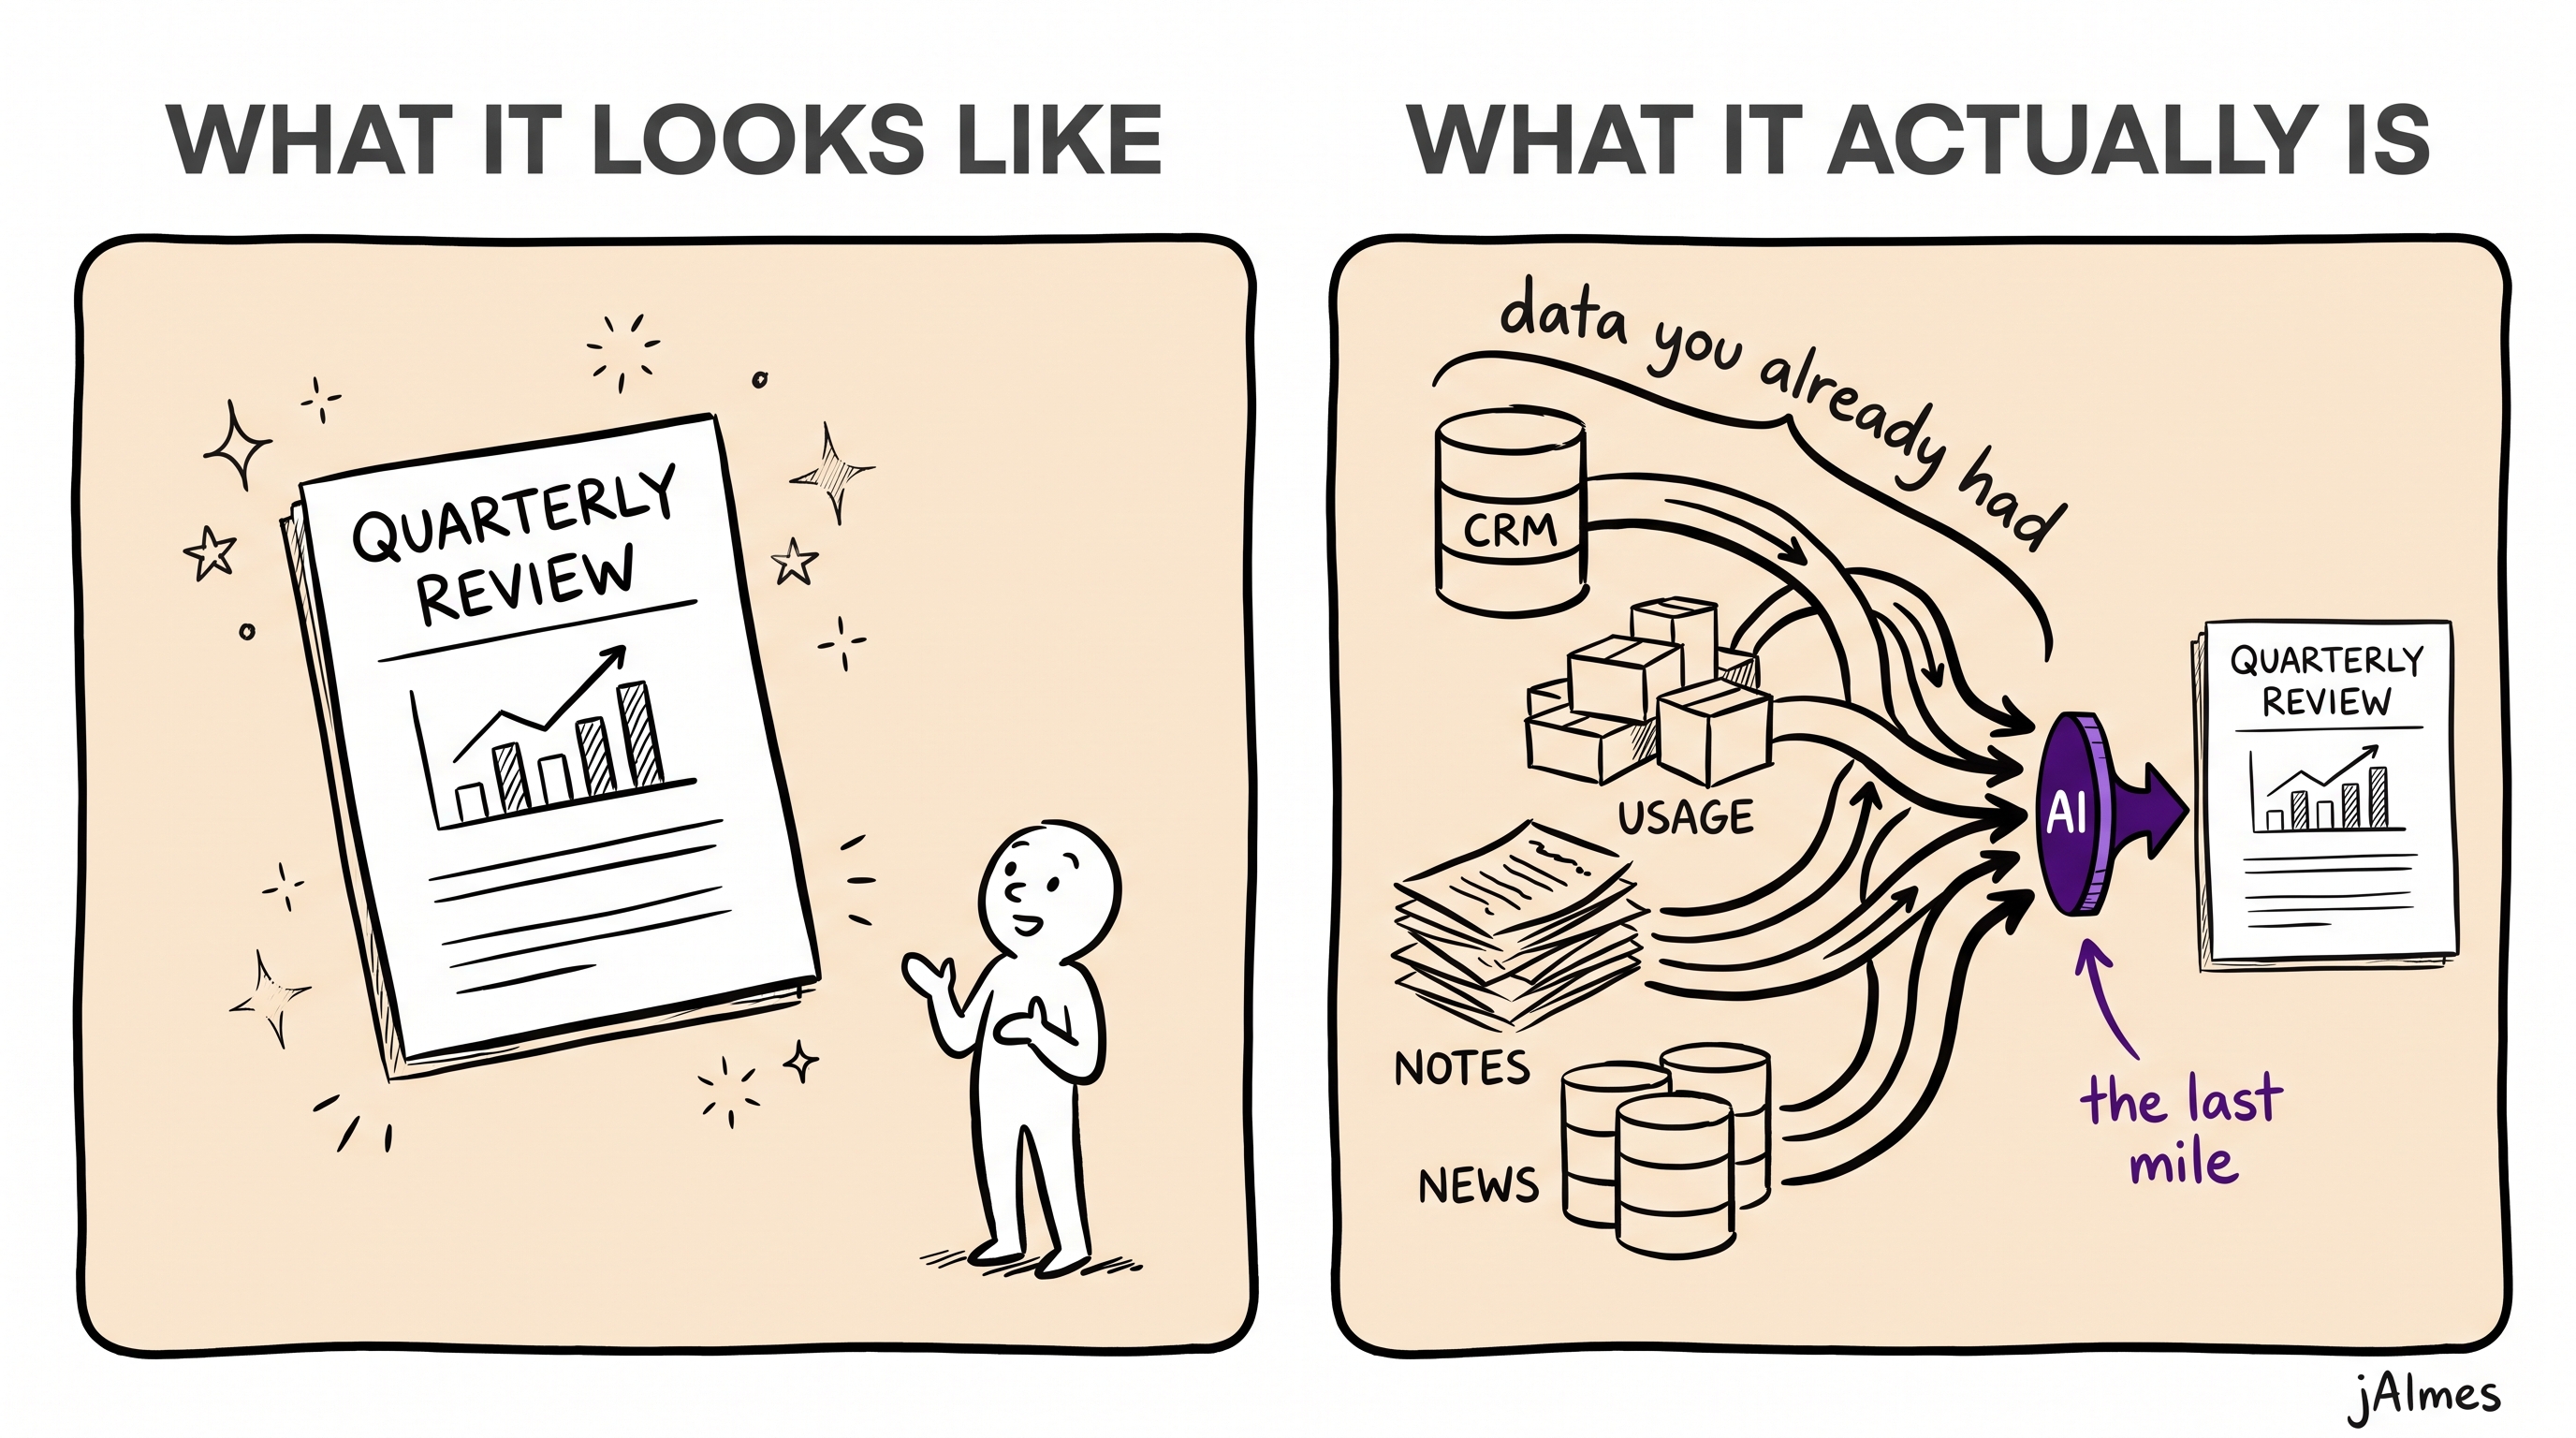
Vor ein paar Wochen habe ich zugesehen, wie ein Account Manager einen Quarterly Business Review zusammenstellte, und einen Moment lang sah es aus, als hätte die KI etwas wirklich Kluges geleistet. Das fertige Dokument zog die Vertragsdaten des Kunden aus unserem CRM, ergänzte, wie sich die Nutzer dieses Kunden im Quartal tatsächlich verhalten hatten, fasste die Meetings der letzten drei Monate zusammen, prüfte Website und aktuelle Nachrichten des Kunden für den Kontext und verglich den Account mit ähnlichen Unternehmen nach Branche und Größe, um zu zeigen, wo sich das Geschäft ausbauen ließe. Es las sich, als hätte ein guter Analyst zwei konzentrierte Tage darauf verwendet.
Bei einem Blick darauf, wie es tatsächlich entstanden war, steckte das meiste nicht in der Klugheit des Modells. Rund achtzig Prozent dieses Reviews waren strukturierte Daten, die ohnehin schon vorhanden waren, in Systemen, die längst liefen. Die Vertragszahlen lagen im CRM. Die Nutzungsdaten lagen in unserer Nutzerdatenbank. Die Liste vergleichbarer Accounts war eine Abfrage. Nichts davon ist neue Intelligenz. Neu war, dass eine einzelne Person all das an einem Nachmittag zu einer einzigen Sicht zusammenführen konnte, zugeschnitten auf ein bestimmtes Gespräch, ohne drei andere Teams vorher um Exporte zu bitten.
Der Abstand zwischen dem Vorhandensein der Daten und einer brauchbaren Sicht darauf ist ein altes Problem, und Business-Intelligence-Teams haben Jahre darauf verwendet, ihn zu schließen. Sie sind weit gekommen. Trotzdem liegt der Anteil der Beschäftigten, die die BI-Werkzeuge tatsächlich nutzen, für die ihr Unternehmen bezahlt, in vielen Erhebungen seit gut einem Jahrzehnt bei etwa dreißig Prozent. Gartner verzeichnet ihn seit rund sieben Jahren nahe neunundzwanzig Prozent, während die meisten Organisationen berichten, ihre Analytics-Nutzung steige weiter. Nur etwa jedes sechste Unternehmen erreicht nach eigener Aussage die volle Nutzung seiner eigenen Dashboards. Die übliche Erklärung ist nicht, dass die Werkzeuge schwach wären. Ein Dashboard zeigt die Daten, die demjenigen zur Verfügung standen, der es gebaut hat, und nicht die Daten, die eine bestimmte Person für eine bestimmte Entscheidung braucht. Also wird es einmal geöffnet, beantwortet die Frage nicht und bleibt danach ungenutzt. Es gibt ein berechtigtes Gegenargument, wonach die Erzählung vom festgefahrenen BI teils ein Messartefakt ist, und selbst wenn man das einräumt, deckt sich die alltägliche Erfahrung mit den Zahlen: Die wenigsten bekamen je eine Sicht, die um ihre eigene Frage herum gebaut war.
Der Quarterly Business Review ist dabei kein Sonderfall. Dasselbe Muster zeigt sich, wenn jemand eine Demo vorbereitet, wenn eine Vertriebskraft ihre offenen Leads anreichert und ordnet oder wenn eine Teamleitung ein Bild davon zusammenstellt, woran das Team tatsächlich gearbeitet hat. Andere Ergebnisse, darunter dieselbe Bewegung: vorhandene strukturierte Daten zu einer Sicht für einen einzigen Zweck zusammenziehen und das Modell darüber eine dünne Schicht Urteilsvermögen legen lassen.
Deshalb beschreibe ich unsere KI-Erfolge inzwischen für mich selbst anders. Das Beeindruckende ist selten, dass das Sprachmodell sich zu einer neuen Erkenntnis durchdenkt. Das Beeindruckende ist, dass das Modell in fünf Systeme zugleich greifen, die richtigen Ausschnitte nehmen und sie so anordnen kann, wie diese eine Person gern arbeitet. Der genuin KI-eigene Beitrag, das Lesen der Transkripte, das Einweben der Nachrichten, das Erkennen ähnlicher Accounts, ist real und erhaltenswert, aber er ist zugleich der kleinere Teil des fertigen Ergebnisses. Das Rückgrat ist das Abrufen und Anordnen von Daten, die bereits strukturiert und bereits vorhanden waren.
Der breitere Markt scheint an derselben Stelle anzukommen, auch wenn die Deutung weniger schmeichelhaft ist als „KI-Durchbruch". Branchenberichte schätzen inzwischen, dass sich der Großteil der KI-Initiativen in Unternehmen auf strukturierte Retrieval-Pipelines stützt statt auf freie Generierung, und sie beschreiben Unternehmens-Assistenten weniger als Antwortmaschinen und mehr als Systeme, die in CRMs, Finanzdatenbanken und APIs greifen und über sie hinweg koordinieren. Bei dieser Beschreibung erkenne ich den Quarterly Business Review sofort wieder.
Was sich also tatsächlich geändert hat, ist nicht, dass die Maschine unser Geschäft endlich verstanden hätte. Eine persönliche Sicht auf Daten aufzubauen, die ohnehin schon vorhanden waren, war früher ein Projekt und ist heute ein Satz. Diese letzte Meile, vorhandene strukturierte Daten in die konkrete Form zu bringen, die eine Person braucht, war immer der teure Teil, und genau dieser Teil ist gerade billig geworden.
Ein guter Teil des Grundes, warum das so schnell billig wurde, ist Infrastruktur. In den letzten anderthalb Jahren hat sich das Anbinden eines Modells an ein laufendes System weitgehend standardisiert. Das Model Context Protocol wuchs von wenigen Millionen Downloads pro Monat Ende 2024 auf fast hundert Millionen Anfang 2026, mit inzwischen Tausenden fertiger Konnektoren. Das Protokoll selbst ist nicht das Interessante. Es zählt, weil es der Grund ist, warum ein Account Manager CRM, Produktanalyse und einen Nachrichten-Feed zusammenführen kann, ohne ein Ticket beim Data Engineering zu öffnen.
Wenn diese Lesart stimmt, verschiebt sich, wo ich Geld investieren würde. Der Reflex, sobald ein KI-Projekt funktioniert, ist der Ruf nach mehr KI: ein stärkeres Modell, ein größeres Kontextfenster, noch eine Copilot-Lizenz. Ergiebiger ist es, sich anzusehen, was die KI-Assets der besten Nutzerinnen und Nutzer tatsächlich tun, und zu zählen, wie viel der Ausgabe bloß Daten abfragt, die ohnehin schon vorhanden waren, und wie viel echtes Nachdenken das Modell wirklich beigetragen hat. In den meisten Beispielen, die mir begegnen, liegt das Gewicht klar auf der Seite der Daten, die längst vorhanden waren. Der Hebel liegt in der Schicht unter dem Modell: diese Daten leicht erreichbar, sauber definiert und günstig zu einer beliebigen Sicht zusammensetzbar zu machen. Konnektoren, Zugang und abgestimmte Definitionen bringen diese Ergebnisse weiter als ein weiterer Benchmark-Punkt.
Es gibt einen Vorbehalt, den ich ernst nehmen gelernt habe, und deshalb behandle ich diese persönlichen Sichten nicht als fertige Produkte. Wenn die zugrunde liegenden Daten nicht kuratiert sind, liefert eine persönliche Sicht bereitwillig eine selbstsichere, sauber formatierte falsche Antwort. Ich habe erlebt, wie ein Assistent das falsche Umsatzfeld zog und übersah, dass ein großer Account Verträge in mehreren Währungen über Regionen hinweg hielt, und eine Zahl ausgab, die stimmig aussah, bis jemand, der das Datenmodell kannte, eine einzige Frage stellte. Das Ergebnis war ansprechend. Die Zahl war falsch. Weil sie leise dem widersprach, was das CRM auswies, stiftete sie mehr Verwirrung als Klarheit, als sie bei der Führungsebene ankam.
Das ist der Moment, in dem eine persönliche Abkürzung zu etwas werden muss, das das Team pflegt: geprüft am echten Datenmodell, mit Definitionen, auf die sich alle einigen, bevor sie geteilt und jedes Quartal erneut ausgeführt wird. Wie Teams diesen Sprung schaffen, vom cleveren Einzel-Workflow zur geteilten Fähigkeit, ohne das Ausprobieren zu ersticken, aus dem er entstanden ist, ist ein Thema für sich, auf das ich getrennt zurückkomme. Für den Moment ist die kleinere Erkenntnis die nützliche. Der Wert lag in Daten, die ohnehin schon vorhanden waren, und wartete nur auf einen günstigen Weg, jedem die eigene Sicht darauf zu geben. Das Modell hat vor allem die letzte Meile geliefert.
Bereit für AI-Workflows, die sich aufbauen?
Ich helfe PM-Teams dabei, von Ad-hoc AI-Nutzung zu integrierten Systemen zu kommen.
Kontakt aufnehmen